はじめに
Clarity.AIで何をしているのか知らず、pythonの1行も触ったことがないと言っている人がいます。そのため、Clarity.AIで扱っているテクノロジースタック(Python、Pandas、pytest)でほぼ毎日行っていることのミニ紹介を作ることにしました
Pandasとスナップショットテスト
Pandasは、データ構造(DataFrame)を作成し、思いつくあらゆる種類の操作を実行できるpythonライブラリです。例えば:
animales = ['perro','gato','cocodrilo']
acciones = ['ladra','juzga','muerde']

dataframe = pd.DataFrame({"animal": animales, "accion": acciones })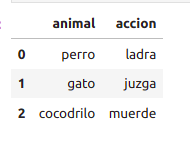
これで、計算、統計、その他多くの操作を実行できる列と行の定義された構造ができました。
一般的に数千のデータポイントを扱う場合、データプロバイダーがそのファイルに触れたり、気づかないうちにコードに変更があって障害を引き起こしたりして、一晩で変更された値があるかどうかを複数回チェックしたい場合があります。このためにいくつかの戦略があり、その1つがスナップショットテストです。
スナップショットテストは、正しいプロセスの結果を比較すること、つまり、関数の現在の結果と「良い」値を比較することです。上記をもう少しよく想像するために、100万行の1つのファイルを提供するデータプロバイダーを考えてみましょう。正の値を含む行に興味があります。値をフィルタリングする関数を作成し、50万行を取得します。ファイルを変更しない限り、それらの行は常に同じであることがわかっています。その場合、結果が変更され、60万行になる可能性があります。スナップショットテストを使用すると、50万行の「有効な」ファイルと比較したときにエラーがあることをすぐに確認できます。
別の例ですが、コードを使用すると、辞書でパラメーターとして渡す値をvalues列で置き換える非常に基本的でシンプルなメソッドから始めることができます
Class Transform:
...
def replace_in_values_column(dataframe: pd.DataFrame, values_to_replace: Dict[int, int]):
    return dataframe.replace(values_to_replace)
...次に、従来のgiven-when-thenスキームに従うテストを定義します:
 class TestUtils:
 def test_replace_values_in_columns(self):
     dataframe = pd.DataFrame({
            "metric": ["metric_a", "metric_b"],
            "metric_year": ["2021", "2021"],
            "value": ["1", "2"]
        })
        expected_dataframe = pd.DataFrame({
         "metric": ["metric_a", "metric_b"],
            "metric_year": ["2021", "2021"],
            "value": ["5", "2"]
        })

     result_df = Transform.replace_in_values_column(dataframe, {"1": "5", "2": "6"})

assert_frame_equal(result_df, expected_df)今見たものはスナップショットテストではありませんが、いくつかのサンプル値を持つ通常のテストです。これを変換するには、dataframeおよびexpected_dataframe変数を外部ファイルからのファイル読み取りメソッドに置き換える必要があります(実際のデータの量と結果の変換を含む別のデータで事前に準備します)。このようにして、1つのデータセットに対して行われる変換が常に同じであることがわかります。
class TestUtils:
 def test_replace_values_in_columns(self):
     dataframe = pd.read_csv('provider_data/december.csv')
        expected_dataframe = pd.read_csv('tests/resources/expected.csv')

     result_df = Transform.replace_in_values_column(dataframe, {"1": "5", "2": "6"})

     assert_frame_equal(result_df, expected_df)
毎月データプロバイダーから情報を取得する自動プロセスがあり、変換フローを壊すものを変更しないことを確認したい場合は、これを行って、通知せずにデータを追加したか、値を変更したかを確認できます。
Parametrize
私たちが扱うもう1つの小さな驚異は、テストをパラメータ化するオプションです。これにより、異なるケースのテストを複製することを節約できます。
Parametrizeはテストのすぐ上で定義され、接続する方法は、parametrizeで定義する変数をテストパラメータとして追加することです:
@pytest.mark.parametrize("filename, expected", [
        ("tests/resources/update_securities.csv", "tests/resources/expected_update_securities.csv"),
        ("tests/resources/master_securities.csv", "tests/resources/expected_master_securities.csv")
])
def test_if_column_names_are_fixed(self, filename, expected):
 update_securities = pd.read_csv(filename)
    expected_df = pd.read_csv(expected)

 result_df =  fix_columns(update_securities)

    assert np.array_equal(expected_df.columns, result_df.columns)
parametrize内の1つの文字列内にfilenameとexpectedという2つの変数を定義します。これらは、パラメーターとしてテストに入り、この場合、ファイルを読み取るときに使用します。このようにして、それぞれに対して1つの異なるテストを作成する必要がなくなります。
同様に、例えば正規表現を満たす変数を定義して、いくつかの文字列が与えられた場合に式を満たすものを選択するようにテストできます。
PatchとFixture
Fixturesは、すべてのテストがアクセスできるデータを提供するために使用されます
@pytest.fixture
def config_key(self):
 return "test_download"

@pytest.fixture
def config_regex(self, config_key, regex):
 config = ConfigParser()
    config.add_section(config_key)
    config.set(config_key, "user", "test_user")
    config.set(config_key, "password", "test_password")
    config.set(config_key, "uri", "sftp://localhost:22")
    config.set(f"{config_key}.op1", "regex", regex)
return configテストクラスのどの時点でも、config_key および config_regexを参照して、新しいテストごとに書き込むことなくデータを取得できます
一方、Patchは、pytestが使用するモックであり、テスト内で使用するものです:
 @mock.patch("Tasks.ftp.Client")
 def test_run_type_regex(self, mock_client, config_regex, config_key):
  task = FTPMove(config_regex, config_key)
    task._download_regex = mock_client.MagicMock()

 task.run()

task._download_regex.assert_called_once()このようにして、Clientクラスがモックされていることをテストに示すことができ、テスト内でパラメーターとして与える名前で参照できます。この場合はmock_clientです。
このようにして、Client内の_download_regex関数をバイパスし、必要な値を返すように指示することもできます(この場合は適用されません)。
コメント